Prompts do GPT Image 2.5: Flare vs Sunburst e Edição
Guia do GPT Image 2.5: compare Flare vs Sunburst, escreva prompts estruturados, evite desvios em edições locais e domine as tarifas da API na Pixapi.
Quem integra geração de imagens na produção costuma enfrentar duas dores de cabeça clássicas: prompts cheios de adjetivos vagos como «8K, obra-prima cinematográfica» que continuam gerando saídas imprevisíveis, e edições locais em que pedir para trocar a jaqueta de um modelo faz a IA alterar também o rosto, o cabelo e o ângulo do sol.
O grande salto do GPT Image 2.5 está na mudança de postura: parar de fazer pedidos mágicos e passar a escrever especificações visuais testáveis. Separamos sujeito, enquadramento, iluminação e restrições negativas, alterando apenas uma variável por vez para poder rodar testes de regressão de verdade.
A OpenAI dividiu a família 2.5 em dois motores: o gpt-image-2.5-flare, ultrarrápido e leve, e o gpt-image-2.5-sunburst, modelo base de altíssima fidelidade. Ambos estão integrados na Pixapi com suporte total ao padrão da OpenAI. Você pode testar e validar suas especificações no Gerador GPT Image 2.5 pagando 2 créditos fixos por imagem e, uma vez afinado, transferir os mesmos parâmetros diretamente para suas chamadas de API.
Sem enrolação teórica, aqui vão as decisões práticas de engenharia: como escolher o motor certo, como estruturar prompts sem desvios e como evitar surpresas na fatura.
Flare versus Sunburst: comparativo de qualidade e custo por imagem aprovada
| Critério de Análise | Flare (gpt-image-2.5-flare) | Sunburst (gpt-image-2.5-sunburst) |
|---|---|---|
| Papel | Focado em velocidade e baixa latência | Focado em qualidade máxima, modelo base robusto |
| Linha de base visual | Equivalente ao GPT Image 2 | Claramente superior ao GPT Image 2 |
| Casos ideais | Lotes grandes, variantes de catálogo, rascunhos | Pôsteres com tipografia, infográficos, retratos, edição fina |
| Rota na Pixapi | Endpoint unificado de imagens | Endpoint unificado de imagens |
| Preço inicial na API | 1 crédito (1K / nível low) | 1 crédito (1K / nível low) |
Um roteiro direto para o seu time testar:
- Se o GPT Image 2 já atende bem o seu produto: Comece testando o Flare. Mantenha os mesmos prompts, imagens de referência e resoluções, medindo o tempo de resposta. Se a taxa de aprovação não cair, você reduz a latência sem esforço.
- Se você sofre com textos borrados, mãos deformadas ou desvios drásticos ao editar: Vá direto para o Sunburst para estabelecer sua referência de qualidade. Se o Sunburst não resolver, o problema quase certamente está na ambiguidade do prompt. Quando funcionar no Sunburst, rode esse mesmo prompt no Flare para ver se o motor leve segura a barra.
- Calcule o custo real por imagem aprovada: O Flare é rápido, mas se você precisar gerar 3 vezes para salvar 1 imagem útil, o custo real e a latência percebida serão piores do que uma única chamada ao Sunburst. Inclua retries, validação humana e desistências no cálculo.
Atenção: mesmo passando quality: "high" em ambos, o Sunburst entrega maior riqueza de texturas e exige mais tempo de processamento que o Flare. Em testes comparativos, mude exclusivamente o campo model. Se a imagem tiver textos densos ou legendas miúdas, comece em medium ou high.
6 regras práticas para escrever prompts estruturados e auditáveis
Um prompt profissional se parece muito mais com um arquivo de configuração estruturado do que com poesia. O guia oficial se resume a seis mandamentos práticos:
1. Defina a entrega antes de falar em estética.
Pedir «uma foto elegante de cosmético» dá zero critério de aceite para o modelo. Escreva uma especificação clara: «Still life para e-commerce com fundo branco, frasco de sérum de vidro fosco centralizado, visão superior a 45 graus, luz difusa suave, sombras de contato limpas». O controle de qualidade só checa três coisas: fundo branco uniforme, ângulo exato e ausência de sombras dispersas.
2. Estruture em blocos claros como um JSON.
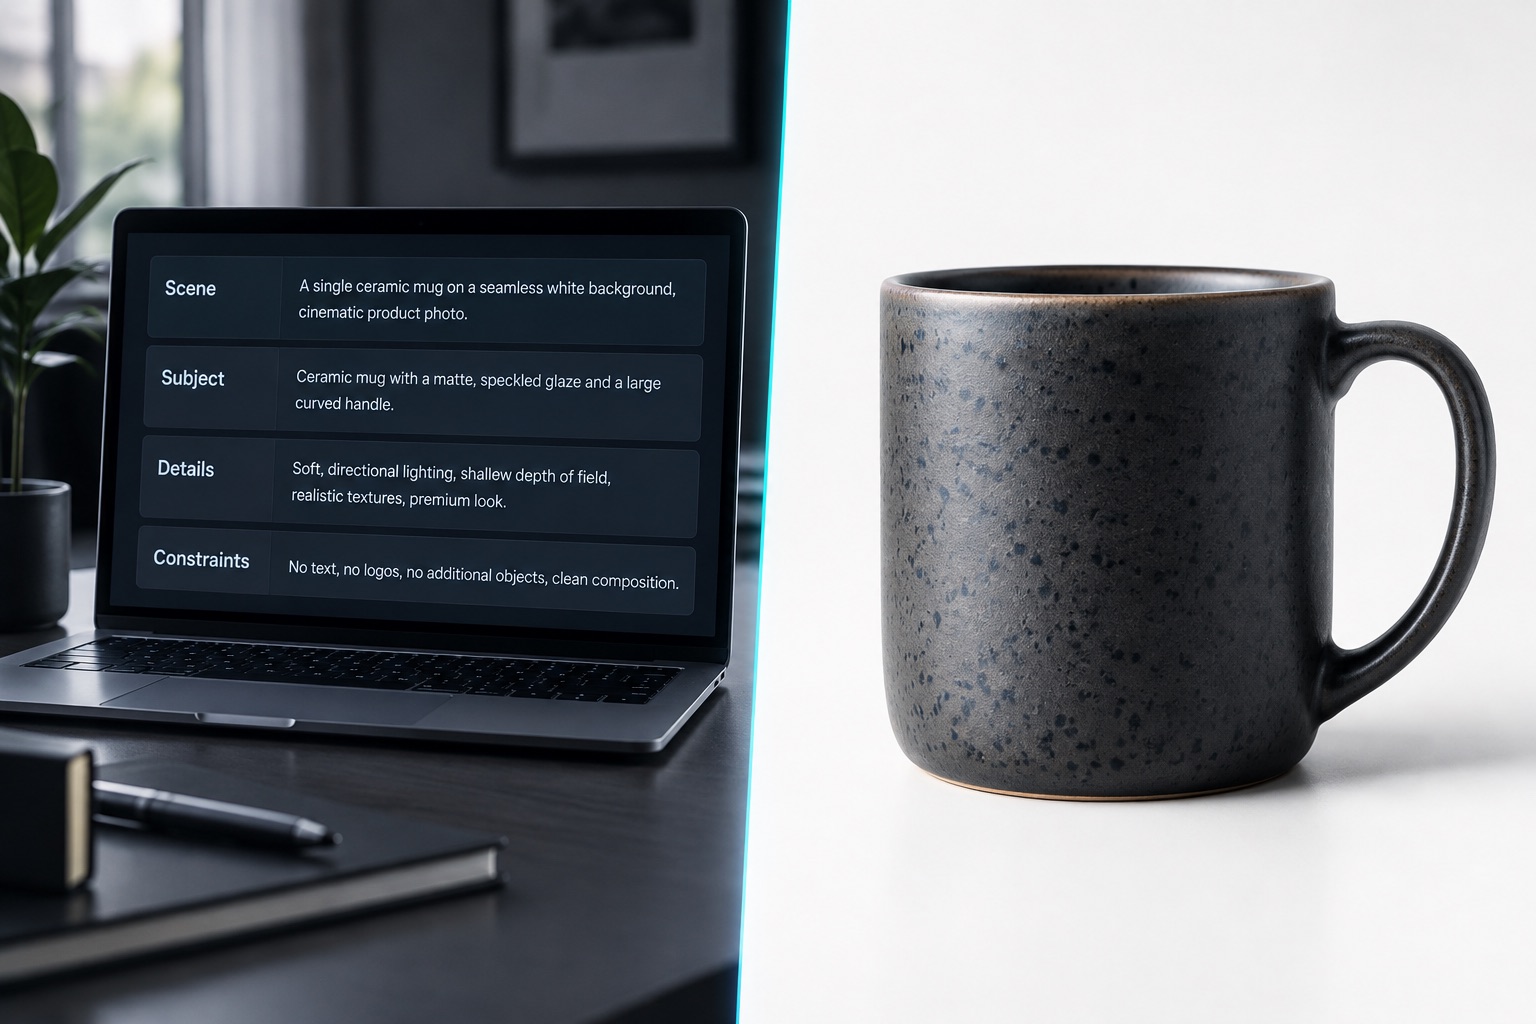
Não amontoe dezenas de instruções em um parágrafo corrido. Separe por tags: [Scene] para ambiente e iluminação, [Subject] para sujeito e pose, [Details] para materiais e acessórios, [Constraints] para elementos proibidos. Prompts modulares facilitam depuração e automação no backend.
3. Use pistas físicas observáveis, não jargões vazios.
Livre-se de termos como «8K fotorrealista». Troque por atributos físicos tangíveis: «textura de pele nítida, luz natural lateral de janela, profundidade de campo reduzida, visual de lente 85mm». Fornecer referências físicas ao modelo é muito mais eficiente do que entupir o prompt de adjetivos.
4. Texto na imagem deve ficar entre aspas e com contagem estrita.
Qualquer texto a ser renderizado na imagem precisa vir entre aspas duplas, declarando explicitamente: «renderizado exatamente uma vez, sem qualquer outro texto adicional na imagem». Seja em pôsteres, embalagens ou telas de UI, revise a ortografia com olhos humanos antes de publicar.
5. Em retoques locais, declare o que muda E a lista de congelamento.
Pedir apenas «troque a jaqueta por uma de couro vermelho» faz o modelo frequentemente redesenhar o rosto, o penteado e a rua. O padrão defensivo é: «Altere exclusivamente a peça superior para uma jaqueta de couro vermelho; mantenha rigorosamente inalterados traços faciais, penteado, postura corporal, fundo urbano e ângulo de iluminação original». Com múltiplas referências, distribua papéis: imagem 1 como base, imagem 2 como objeto a extrair e imagem 3 como referência de material.
6. Uma única variável por iteração.
Não tente trocar o fundo, redimensionar a pessoa, diminuir a luz e colocar óculos escuros na mesma chamada de edição. Avance um passo de cada vez, reaproveitando a imagem aprovada da rodada anterior. Se sua regra de negócio exige que certas partes fiquem 100% idênticas no nível dos pixels, não conte com o texto como uma máscara infalível: use código para compor o recorte gerado sobre a imagem original.
Template estruturado pronto para usar:
[Task] Gerar / Editar um <tipo de entrega>
[Subject] Aparência do sujeito, postura, direção do olhar, traços essenciais
[Style] Acabamento de material, luz ambiente, temperatura de cor, referência de lente
[Text] Renderizado exatamente uma vez: "<texto literal exato>"
[Constraints] Alterar apenas ...; manter rigorosamente ...; proibir textos extras, marcas d'água e falso tabuleiro de xadrez
4 fluxos de produção essenciais: tipografia, infográficos e consistência
Estes quatro cenários concentram o grosso das chamadas reais na Pixapi:
- Criativos comerciais com tipografia: Crave marcas, slogans e valores promocionais com posições e contagens exatas, proibindo logomarcas falsas ou marcas d'água. Continua sendo a maior vantagem competitiva da linha GPT Image.
- Infográficos, diagramas e slides: Trate setas, gráficos e métricas como marcadores visuais. Uma imagem atraente não é sinônimo de rigor técnico: fluxos, fórmulas e dados financeiros devem ser auditados por pessoas antes da publicação.
- Edições pontuais e catálogos: Trocas de roupas, móveis ou recorte de produtos. Quanto mais curto o prompt, mais rígida deve ser a trava sobre o resto da imagem. Valide se mãos, sombras e bordas do produto permaneceram intactas.
- Consistência de personagens entre rodadas: Gere a imagem âncora primeiro e altere apenas ações ou itens secundários nos passos seguintes. Na segunda rodada, reforce: «mesmo rosto, mesma roupa base, mesma paleta de cores».
Fundo transparente: a Pixapi suporta saída com canal alfa real. Peça no prompt «fundo totalmente transparente, canal alfa limpo, estritamente sem falso padrão de tabuleiro de xadrez cinza e branco». Abra o arquivo em um editor gráfico com suporte a canais alfa reais em vez de confiar na miniatura do navegador.
Chamadas de API na Pixapi: exemplos de código e resolução
Antes de escrever código de produção, teste seus prompts no Gerador GPT Image 2.5. O Lab permite alternar entre gpt-image-2.5-sunburst e gpt-image-2.5-flare a 2 créditos fixos por execução, ajudando a travar a especificação com custo mínimo.
Chamadas padrão em produção:
1. Geração de texto para imagem (POST /v1/images/generations)
curl -X POST https://api.pixapi.ai/v1/images/generations \
  -H "Authorization: Bearer $PIXAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.5-flare",
    "prompt": "[Scene] estúdio claro [Subject] frasco de sérum de vidro fosco centralizado [Details] plongée a 45 graus, luz suave sem sombras soltas, texto do rótulo uma só vez [Constraints] fundo branco contínuo, sem marcas d água",
    "size": "1024x1024",
    "quality": "low"
  }'
Para obter o máximo em nitidez e detalhes, basta trocar model para gpt-image-2.5-sunburst e definir quality como high.
2. Retoque e edição de imagens (POST /v1/images/edits)
curl -X POST https://api.pixapi.ai/v1/images/edits \
  -H "Authorization: Bearer $PIXAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.5-sunburst",
    "prompt": "Substitua apenas o fundo por uma mesa de madeira minimalista com luz lateral suave. Mantenha rigorosamente a geometria do frasco de sérum original, tipografia do rótulo, ângulo de câmera e direção das sombras.",
    "image": "https://cdn.example.com/original-bottle.png",
    "size": "auto",
    "quality": "high"
  }'
Para lotes volumosos e chamadas assíncronas sem travar threads, envie requisições para POST /v1/async/images/generations e POST /v1/async/images/edits, consultando periodicamente o status do trabalho. A lista completa de parâmetros está descrita no Guia do GPT Image, com folhas de referência específicas na Documentação do Flare e na Documentação do Sunburst.
Limites de dimensões personalizadas: ambos os lados precisam ser múltiplos de 16, a borda maior não pode ultrapassar 3840 pixels, a proporção deve ficar até 3:1 e o total de pixels entre 655.000 e 8.294.000. Qualquer dimensão acima de 2560×1440 entra em faixa experimental. A Pixapi agrupa cobranças nas faixas 1K, 2K ou 4K com base na maior borda; enviar size=auto enquadra por padrão na faixa 1K.
Preços reais da API e armadilhas na fatura: economia e escala
1 crédito equivale a $0.01. Flare, Sunburst e o GPT Image 2 legado compartilham a mesma matriz de preços:
| Faixa de tamanho | Borda maior máx. | Nível low | Nivel medium | Nível high / auto |
|---|---|---|---|---|
| 1K Padrão | ≤ 1536px | 1 crédito ($0.01) | 4 créditos ($0.04) | 14 créditos ($0.14) |
| 2K HD | ≤ 2048px | 2 créditos ($0.02) | 17 créditos ($0.17) | 67 créditos ($0.67) |
| 4K UHD | ≤ 3840px | 4 créditos ($0.04) | 34 créditos ($0.34) | 133 créditos ($1.33) |
Armadilhas financeiras para evitar:
- O perigo do quality padrão: Omitir o campo
qualityna requisição faz o sistema assumirauto, cobrado na faixahigh(mínimo de 14 créditos). Durante fases de teste e desenvolvimento, declare explicitamente"quality": "low"(1 crédito / $0.01) para economizar mais de 90%. - Desligamento de modelos antigos: A OpenAI desativará o
gpt-image-1em 23 de outubro de 2026 e ogpt-image-1.5em 1 de dezembro de 2026. Atualize suas integrações para GPT Image 2 ou 2.5 e elimine parâmetros legados comoinput_fidelity. - Recargas e pacotes de créditos estão disponíveis na página de preços.
Checklist de 6 itens antes de abrir para produção
Passe por esta lista antes de liberar tráfego real:
- Tipografia: O texto está escrito corretamente, aparece uma única vez e não deixou resíduos ou marcas d'água falsas?
- Geometria do sujeito: As proporções do produto, contornos da marca e detalhes da imagem de referência foram preservados?
- Limites da edição: A alteração ficou restrita à área combinada, sem deformar mãos, sombras ou elementos de fundo?
- Transparência real: O arquivo exportado traz um canal alfa autêntico em vez de um tabuleiro quadriculado simulado?
- Parâmetro de qualidade: Seus scripts de teste declararam expressamente
"quality": "low"para não inflar a conta? - Opção de contingência: Seu backend mantém uma flag de configuração para retornar instantaneamente ao
gpt-image-2se necessário?
Um bom prompt não é um jogo de sorte: é uma especificação técnica transparente. Defina regras de aceite sólidas e teste Flare e Sunburst lado a lado na Pixapi para construir pipelines de imagem estáveis e econômicos.
Experimente agora no Gerador GPT Image 2.5 ou gere sua chave no Guia de Início Rápido.
Leituras recomendadas e recursos adicionais
- Comparativo de modelos: GPT Image 2 vs Nano Banana: Comparativo de APIs para Devs
- Ecossistema Google: Guia da API Gemini 3 Pro Image e Tarifas
- Geração de vídeo: Preços da API do Seedance e Estimativa de Custo
- Tabela de créditos: Tabela de Preços e Planos da Pixapi
Perguntas frequentes
Flare versus Sunburst: como escolher o modelo ideal?
Não escolha no feeling. O Flare é o modelo leve focado em velocidade e baixa latência, com qualidade comparável ao GPT Image 2; é perfeito para variantes multi-SKU, geração em lote e rascunhos ágeis. Já o Sunburst é o motor base pesado, projetado para renderizar textos nítidos, infográficos complexos, retratos realistas e retoques cirúrgicos. Na Pixapi ambos usam as mesmas rotas e tabela de créditos: avalie sua bateria real de prompts e decida pelo custo por imagem aprovada e tempo de resposta.
Quanto custa a API do GPT Image 2.5 na Pixapi?
A API segue à risca as tarifas do GPT Image 2: na resolução 1K, o nível low custa apenas 1 crédito ($0.01) e high/auto custa 14 créditos ($0.14); 2K high sai por 67 créditos e 4K high por 133. O Lab interativo (/gpt-image-2-5-image-generator) cobra 2 créditos fixos por geração, ideal para travar o prompt antes de subir para o backend.
Por que edições locais sofrem desvio mesmo com prompt longo?
Um prompt detalhado aumenta a fidelidade do modelo, mas não garante fixação pixel a pixel. Ao pedir uma troca de roupa, o modelo costuma alterar o rosto ou a iluminação de fundo por conta própria. Defina sempre uma «lista de congelamento» clara. Se sua aplicação exige que certas áreas fiquem 100% inalteradas, recomponha o patch gerado sobre a imagem original usando máscaras tradicionais em código em vez de confiar apenas no prompt.
Quando gpt-image-1 e 1.5 serão desativados? Como migrar?
A OpenAI já definiu o cronograma de desligamento: a versão 1.0 sai do ar em 23 de outubro de 2026 e a 1.5 em 1 de dezembro de 2026. Recomendamos migrar primeiro para o gpt-image-2 para garantir estabilidade e depois avaliar o 2.5. Na Pixapi, basta atualizar a string model no corpo das requisições JSON e retirar parâmetros obsoletos como input_fidelity.